
那每幀音素對應哪個狀態呢?有個容易想到的辦法,看某幀對應哪個狀態的概率最大,那這幀就屬于哪個狀態。比如下面的示意圖,這幀對應 S3 狀態的概率最大,因此就讓這幀屬于 S3 狀態。
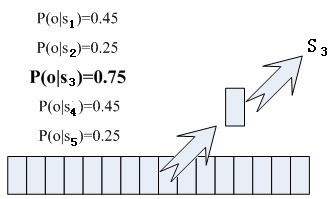
那這些用到的概率從哪里讀取呢?有個叫“聲學模型”的東西,里面存了一大堆參數,通過這些參數,就可以知道幀和狀態對應的概率。獲取這一大堆參數的方法叫做“訓練”,需要使用巨大數量的語音數據,訓練的方法比較繁瑣,這里不講。
但這樣做有一個問題:每一幀都會得到一個狀態號,最后整個語音就會得到一堆亂七八糟的狀態號,相鄰兩幀間的狀態號基本都不相同。假設語音有 1000 幀,每幀對應 1 個狀態,每 3 個狀態組合成一個音素,那么大概會組合成300個音素,但這段語音其實根本沒有這么多音素。如果真這么做,得到的狀態號可能根本無法組合成音素。實際上,相鄰幀的狀態應該大多數都是相同的才合理,因為每幀很短。
解決這個問題的常用方法就是使用隱馬爾可夫模型(Hidden Markov Model,HMM)。這東西聽起來好像很高深的樣子,實際上用起來很簡單:
第一步,構建一個狀態網絡。
第二步,從狀態網絡中尋找與聲音最匹配的路徑。
這樣就把結果限制在預先設定的網絡中,避免了剛才說到的問題,當然也帶來一個局限,比如你設定的網絡里只包含了“今天晴天”和“今天下雨”兩個句子的狀態路徑,那么不管說些什么,識別出的結果必然是這兩個句子中的一句。
那如果想識別任意文本呢?把這個網絡搭得足夠大,包含任意文本的路徑就可以了。但這個網絡越大,想要達到比較好的識別準確率就越難。所以要根據實際任務的需求,合理選擇網絡大小和結構。
搭建狀態網絡,是由單詞級網絡展開成音素網絡,再展開成狀態網絡。語音識別過程其實就是在狀態網絡中搜索一條最佳路徑,語音對應這條路徑的概率最大,這稱之為“解碼”。路徑搜索的算法是一種動態規劃剪枝的算法,稱之為 Viterbi 算法,用于尋找全局最優路徑。

這里所說的累積概率,由三部分構成,分別是:
觀察概率:每幀和每個狀態對應的概率
轉移概率:每個狀態轉移到自身或轉移到下個狀態的概率
語言概率:根據語言統計規律得到的概率
其中,前兩種概率從聲學模型中獲取,最后一種概率從語言模型中獲取。語言模型是使用大量的文本訓練出來的,可以利用某門語言本身的統計規律來幫助提升識別正確率。語言模型很重要,如果不使用語言模型,當狀態網絡較大時,識別出的結果基本是一團亂麻。
這樣基本上語音識別過程就完成了。
以上介紹的是傳統的基于 HMM 的語音識別。事實上,HMM 的內涵絕不是上面所說的“無非是個狀態網絡”那么簡單。以上的文字只是想讓大家容易理解,并不追求嚴謹。