
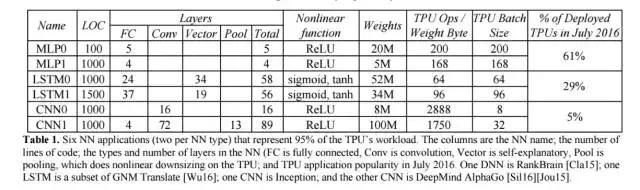
表 1:6 種神經網絡應用(每種神經網絡類型各 2 種)占據了 TPU 負載的 95%。表中的列依次是各種神經網絡、代碼的行數、神經網絡中層的類型和數量(FC 是全連接層、Conv 是卷積層,Vector 是向量層,Pool 是池化層)以及 TPU 在 2016 年 7 月的應用普及程度。RankBrain [Cla15] 使用了 DNN,谷歌神經機器翻譯 [Wu16] 中用到了 LSTM,Inception 用到了 CNN,DeepMind AlphaGo [Sil16][Jou15] 也用到了 CNN。
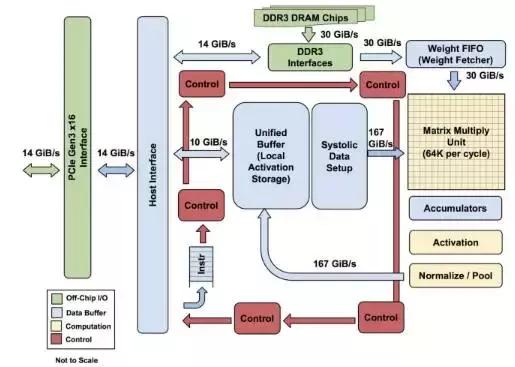
圖 1:TPU 各模塊的框圖。主要計算部分是右上方的黃色矩陣乘法單元。其輸入是藍色的「權重 FIFO」和藍色的統一緩存(Unified Buffer(UB));輸出是藍色的累加器(Accumulators(Acc))。黃色的激活(Activation)單元在Acc中執行流向UB的非線性函數。

圖 2:TPU 芯片布局圖。陰影同圖 1。藍色的數據緩存占芯片的 37%。黃色的計算是 30%。綠色的I/O 是 10%。紅色的控制只有 2%。CPU 或 GPU 中的控制部分則要大很多(并且非常難以設計)。
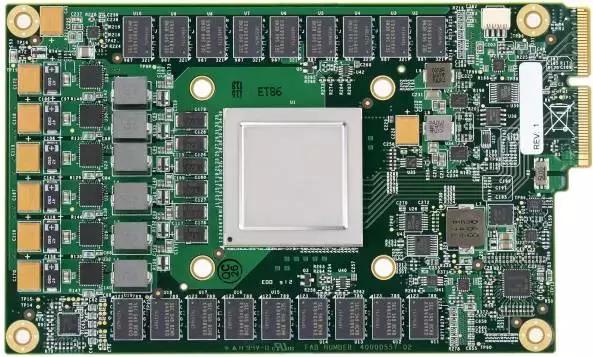
圖3:TPU印制電路板。可以插入服務器 SATA 盤的卡槽,但是該卡使用了 PCIe Gen3 x16 接口。
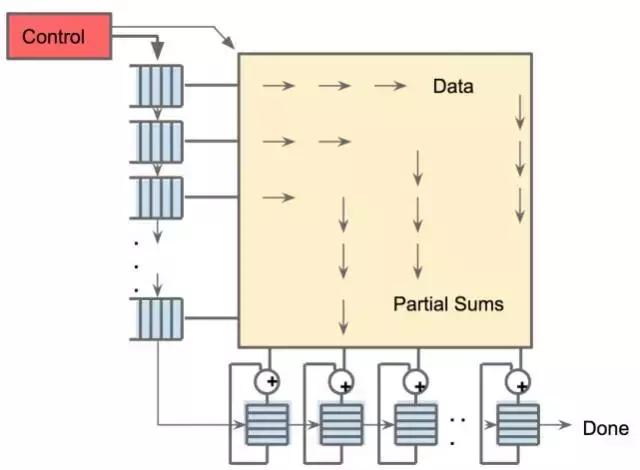
圖4:矩陣乘法單元的 systolic 數據流。軟件具有每次讀取 256B 輸入的錯覺,同時它們會立即更新 256 個累加器 RAM 中其中每一個的某個位置。