
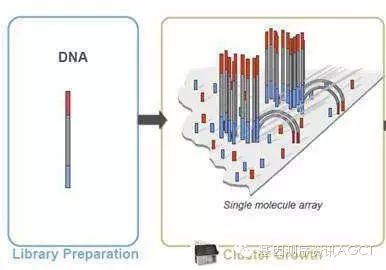
完整的二代測序工作流程都包括5個環節:核酸提取,文庫制備,簇生成,測序,數據分析。
本文講述illumina公司NGS文庫上機前的準備工作:核酸提取、文庫構建、簇生成。
1 核酸提取 (DNA/RNAExtraction)
按照常規方法從培養的細胞、外周血、新鮮冷凍組織或石蠟包埋組織(FFPE)等不同種類的樣本中提取DNA、總RNA或者小RNA,然后進行純化、定量。DNA和RNA樣本質量越高、片段越完整越好。慎重對待從降解的樣本、細胞凋亡的樣本(DNA也被破壞、降解)獲得的二代測序數據。二代測序雖然能產生海量數據,但是它對樣本的消耗并不大。標準流程只需要0.1-1 μg DNA或者RNA,低量流程(low input)所需樣本量可由各個實驗室根據自身條件和經驗把握。二代測序對核酸樣本的質量也沒有額外要求,整體上與其他分子生物學實驗相同。比如說,DNA的OD260/280在1.8-2.0之間;RNA的RIN值>=8.0。RIN值由Agilent 2100 Bioanalyzer測定。實驗中發現,只要RIN值大于7,就可以獲得比較滿意的結果。
2 文庫制備 (LibraryConstruction)
二代測序的應用種類繁多,常見的比如基因組測序、外顯子組測序、轉錄組(mRNA)測序、microRNA測序、甲基化測序、ChIP-Seq、單細胞測序等等。不同的應用,其文庫制備的具體流程也不同。以基因組測序為例:基因組DNA文庫構建在所有種類的二代測序文庫構建方法中處于核心的地位,其他流程和方法都是在此基礎上衍生變化出來的。
基因組DNA文庫構建的基本過程是:首先把完整的長鏈DNA隨機打斷成長度為350 bp左右的短片段,然后在每個短片段的兩端都連接上帶有barcode的接頭,再經過12循環左右的PCR對文庫放大。簡而言之:片段化、連接、擴增“三板斧”,期間穿插進行一些純化、定量的輔助步驟。
2.1 片段化
運用高壓氣體的霧化作用、超聲波的氣穴作用、普通超聲波、酶等手段、設備,將完整的長鏈DNA分子打斷成短片段,原則是斷點越隨機越好,片段長度越集中越好。通常打斷后的片段長度以350堿基左右為宜。當然,不同的應用也可能會要求取得不同的長度,這可以通過優化、修改片段化的參數條件來獲得。一般而言,SR測序的模板長度約350堿基,PE測序的模板長度約500堿基,MP測序的模板長度約1k-10k堿基。
超聲波片段化獲得的片段集合在長度上接近正態分布。片段化后,可以切割瓊脂糖凝膠電泳條帶,或者組合運用不同緩沖液條件下的磁珠純化來進一步收窄片段長度范圍,精準選擇所需長度。當然,也可以不進行片段長度選擇,直接進行下一步。選擇和不選擇兩種方法對二代測序數據的影響沒有顯著差異。不進行割膠選擇片段長度的文庫構建路徑稱為gel-free方法。
2.2 末端修補
用物理方法打斷所獲得的DNA片段,其兩個末端往往都被破壞,結構不完整,基本上不再是平末端,影響接頭連接,所以要對它們進行修補,把它們修復成平末端。一般而言,末端修補要用到3種酶:5’端延伸的酶,5’端連接的酶,以及3’端延伸的酶。
2.3 3’端加A
為了提高連接效率,也為了防止接頭與插入片段以多種方向連接,同時減少接頭之間的互聯,接頭與插入片段之間的連接采用TA半粘性末端的連接方式。這就要求接頭的3’端帶有一個突出的T堿基,插入片段的3’端帶有一個突出的A堿基。
2.4兩端加接頭
由于接頭的3’端有一個突出的T堿基,它們與插入片段進行連接的時候,接頭是定向的,但是插入片段本身則兩個方向都能被連上。
考慮到很多應用都需要把來自不同樣本的文庫混合在一起進行測序,所以現在廠家提供的接頭都包含有序列已知的barcode區域,以方便測序完成后對數據進行拆分。這些接頭按barcode序列進行編號,所以在進行接頭連接這一步實驗操作的時候,要特別小心不要把barcode編號與樣本之間的對應關系搞錯。
另外,不同的應用,其接頭在序列和結構上都有可能不一樣。比如SR測序與PE測序,它們的接頭和flow cell都不一樣,不能混用。
2.5 連接產物純化
由于連接酶的效率問題,連接反應必定是不完整的,除了兩端都有接頭的完整產物外,還會生成一定比例的多種副產物。這些副產物包括包括一端有一端無、兩端都沒有、空接頭自連、游離的接頭等幾種情況。對連接產物進行純化,目的就是選出完整的連接產物,去除殘缺不全的副產物。純化方法可以是對瓊脂糖凝膠電泳條帶進行切割,也可以組合運用不同條件的磁珠純化。目前人們更傾向于運用磁珠純化方法。
2.6 PCR富集
使用一對通用引物,對連接產物進行10-12個循環的PCR。PCR可以同時起到兩方面的作用。一方面,它可以顯著增加文庫量,方便上機測序;另一方面,它還可以對兩端都連接有接頭的完整的連接產物進行富集,降低殘留的連接副產物在文庫中所占的比例。
人們對PCR也存在一定程度的擔心,那就是擔心PCR會認為引入數據偏差(bias)。若是不喜歡PCR,可以省略這一步。不進行PCR的文庫構建路徑稱為PCR-free方法。
2.7 文庫質檢
PCR完成后,需要采用磁珠、過柱或其他方法對PCR產物進行純化,然后進行文庫的定量和質檢,為上機進行cluster生成作好準備。
文庫質檢可以選擇以下方法:瓊脂糖凝膠電泳檢查PCR產物長度是否符合預期、是否有雜帶、是否有污染、是否有引物二聚體殘留等待;Agilent 2100 Bioanalyzer或者其他設備測定文庫的片段長度及長度分布;Qubit或其他設備測定文庫的質量濃度。結合Qubit和2100數據,可以計算出文庫的摩爾濃度。
然后把文庫統一稀釋到指定的摩爾濃度(濃度歸一化)。不同的測序平臺,具體要求的文庫濃度不一樣。根據項目設計的要求決定是否混合不同的文庫、以及按什么樣的比例進行混合。在混合文庫的時候,要格外留意barcode是否存在沖突。一定不要把barcode相同的文庫混合到一起。一旦被混合,它們就再也無法分離,兩個文庫都需要重新構建。
3.0 簇的生成 (ClusterGeneration)
簇生成(clustergeneration)的生化反應是在flow cell內進行的。在很多領域,flow cell被翻譯成“流動池”。但是對于二代測序而言,這樣的翻譯詞不達意。因為二代測序的flow cell并不是一個杯子,而是貫穿一張玻璃片的一排8條長長的隧道(lane),高度特化。無奈之下,人們只好選擇不翻譯,直接說英文,或者使用其簡稱FC。同樣,lane是否翻譯成“通道”,cluster是否翻譯成“簇”,都很尷尬。
Clustergeneration要用到專門的儀器cBot;另外在MiSeq、快速HiSeq 2500等少數幾種型號的測序儀上也能進行。除了加文庫、安裝試劑板、設置運行參數等必要的準備工作以外,cluster generation是一個高度自動化的過程,運行過程中不需要人工干預。整個過程歷時大約4小時。
簇生成的生化反應步驟主要有5步:文庫模板雜交、橋式PCR、線性化、末端封閉和測序引物雜交。
以下文庫處理步驟涉及把雙鏈DNA變性成單鏈,其產物不穩定,需要在開始cluster generation前新鮮進行:經過純化(去除引物二聚體等)、定量、濃度歸一化之后的DNA文庫(不論原始材料是DNA還是RNA,文庫都是雙鏈DNA),加入NaOH進行堿變性,再加入緩沖液進一步稀釋,把文庫濃度調整到pM或者nM級別,分裝一部分到8連管中,置冰上準備上機。
注意:不同的測序平臺,所要求的文庫濃度不同;有的平臺其上機濃度是固定的,不需調整;有些平臺允許調整文庫濃度,我們可以通過這種方法來調整、控制每個樣本、每條lane的數據量,從而使整張FC的測序數據量最大化。
3.1 文庫雜交
通過cBot或者部分型號的測序儀把變性后的文庫引入flow cell,單鏈文庫的DNA片段隨機地與分布在FC通道(lane)內壁(包括上層和下層兩面)上的接頭雜交;接頭隨即被延伸,合成互補鏈,互補鏈與FC的內表面之間是通過共價鍵結合的,因而被固定到FC上的一定位置,而原來的模板單鏈則在NaOH堿變性后被沖去。
3.2 橋式擴增
固定在FC上的DNA單鏈(原文庫的互補鏈)的另一端與FC內壁的另一種接頭因為堿基序列互補而發生分子雜交,形成橋狀結構,在DNA聚合酶的作用下,合成其互補鏈。這一雙鏈的DNA“分子橋”在NaOH的作用下堿變性,形成2條單鏈,又可以再次與其他互補接頭雜交而形成2個新的“分子橋”,從而再次被擴增。這一過程重復20次左右,稱為橋式PCR (bridge PCR)。最終,每條單鏈模板都被克隆成1000-6000條序列一模一樣的單鏈,而且集中在一起,形成一簇(cluster)。
通過橋式PCR,每平方毫米面積的FC內壁上,包括頂層和底層,都隨機分布著上百萬個cluster。
3.3 線性化
橋式PCR形成的cluster雖然是單鏈,但是里面包含有等量的正義鏈和反義鏈,其序列相互互補,所以在每一個位置上都存在兩種堿基。這將導至測序時,每個cluster的每個循環都存在兩種顏色的熒光,無法獲得純凈的熒光信號。因此,需要去除其中一個方向的全部單鏈,只保留一種序列。這一過程稱為線性化。
廠家在FC的內表面上預先固定有兩種接頭,它們分別與文庫的上游和下游接頭序列互補。這兩種接頭里分別設置有一個能被不同的酶(不是限制性內切酶)切割的位點,因而可以定向切斷一條方向的單鏈并通過堿變性、緩沖液沖洗而去除它們,從而完成線性化。
3.4 末端封閉
邊合成邊測序的本質是DNA鏈延伸。為了確保測序時只有測序引物被延伸,在測序引物雜交之前,FC上所有游離的DNA片段的末端都必須進行封閉,使之不能延伸,從而不會干擾測序信號的純凈。末端封閉是通過在DNA片段的游離末端增加一個ddNTP而完成的。
3.5 引物雜交
把測序引物灌注進FC的所有lane里,這些引物就會雜交到每個cluster里每條DNA片段的通用引物結合位點上。
至此,FC準備就緒,可以拿到測序儀上真的開始測序了。
注意:cluster generation最好在測序前新鮮進行。Cluster完成后,越快測序越好。